TL;DR
Brazilian Portuguese TTS voices speak an accent that belongs to no region, and that inconsistency can separate synthetic from natural speech at 6.09% EER with an entire TTS provider and an entire natural corpus held out.
The three markers — click a realization to hear it
/s/ in coda
pasta
/r/ in coda
porta
/d/, /t/ before /i/
dia · tia
Each clip is a 160 ms window centred on a ZIPA-detected phone spike in an annotated natural recording — the exact unit the paper extracts features from. Click a realization repeatedly to cycle through three different speakers. These are the natural realizations a Brazilian listener places regionally without effort; the claim of the paper is that synthetic voices sit between them.
Non-exhaustive examples of regionalistic realizations. Hover a unit for its full entry, or click it to hear the realization shaded there. A shaded unit means the realization is documented there, not that it is uniform across the unit or absent elsewhere.
Research Questions & Answers
Yes. A Kernel Density Estimator fitted only on the 364 natural speakers flags synthetic voices as out-of-distribution, reaching 93.9% AUROC on a transductive t-SNE 2D projection and 74.3% on a deployable inductive Isomap 15D projection (72.1% for PCA 5D). No synthetic sample is seen during fitting.
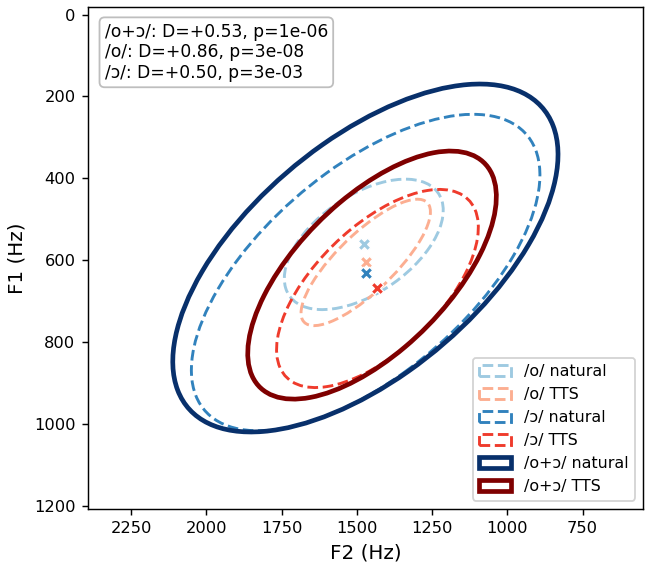
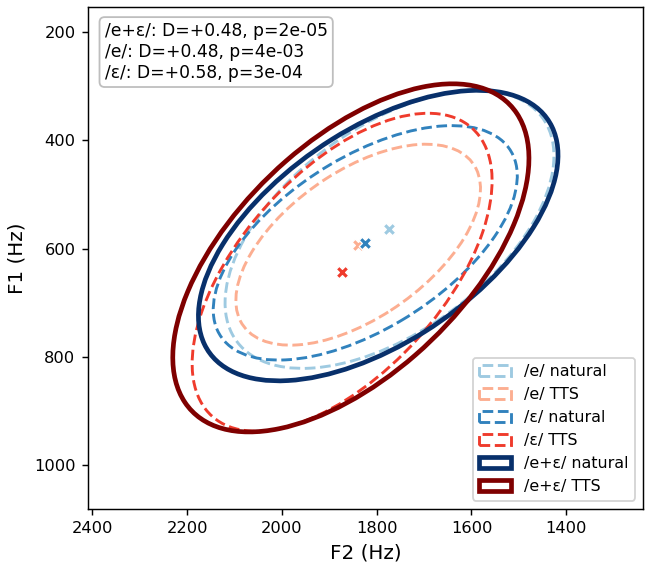
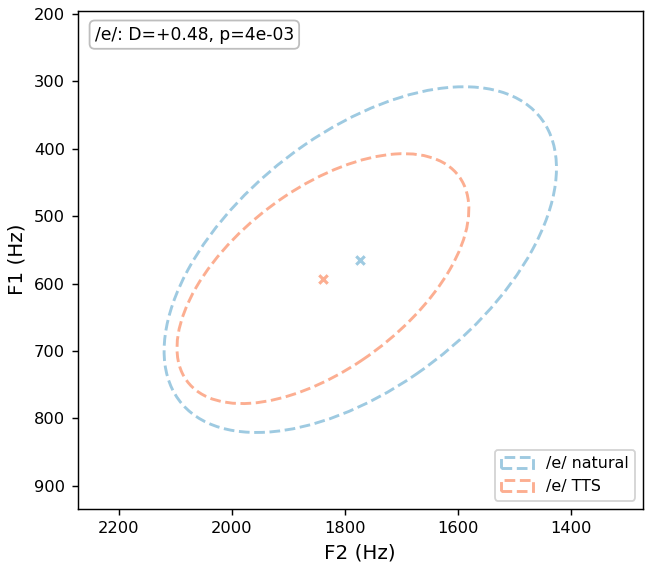
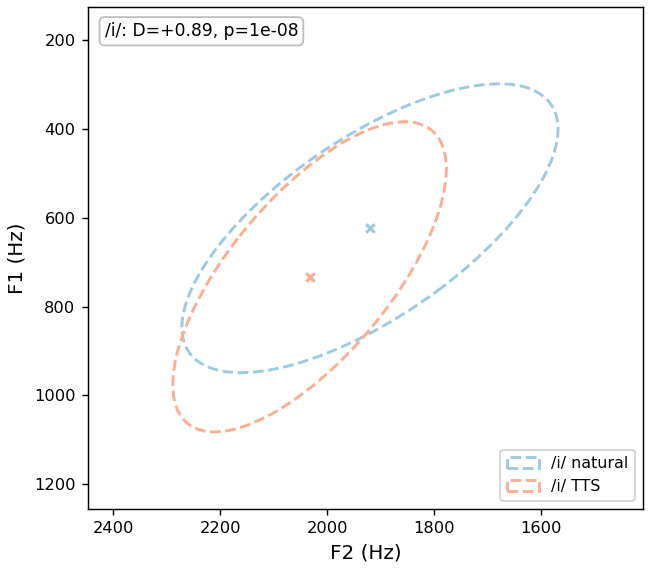
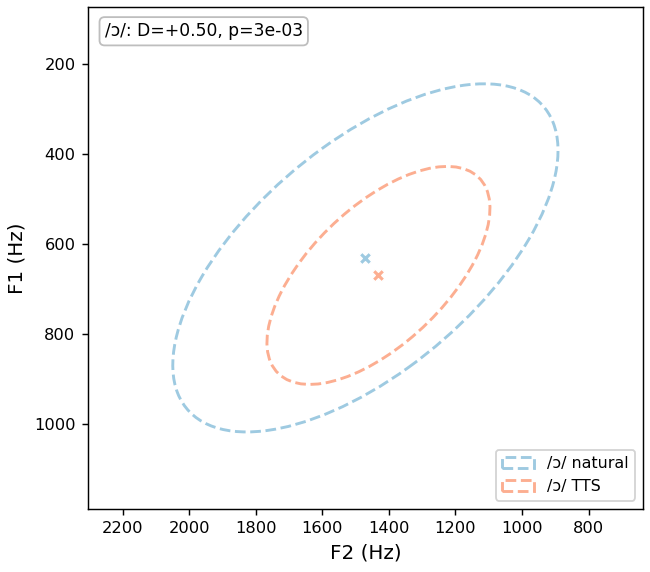
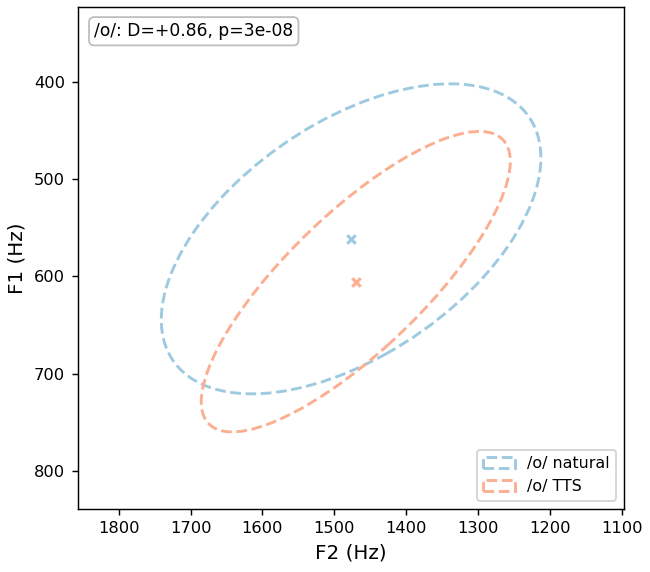
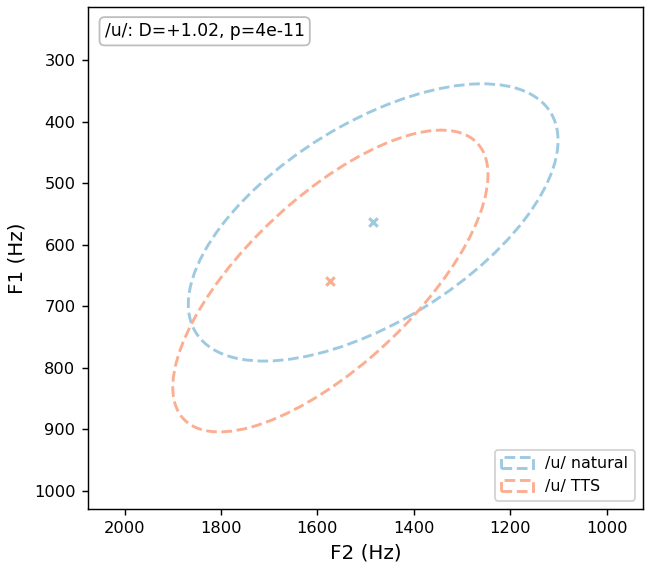
Synthetic voices show shifted sibilant realizations at /s/ coda (Cliff’s δ = +0.77), a distorted spectral shape at /r/ coda (δ = +0.66), a narrower and displaced /o/–/ɔ/ vowel space, and more within-utterance realization switching for /r/ coda and /d,t/ palatalization (δ = +0.49 and +0.55 per utterance). The feature distributions and the switching statistics below extend the paper’s Figures 3 and 4.
On BRSpeech-DF official splits the best configuration reaches 2.00% EER, against 30.67% for the SLS-ECAPA baseline. On FakeBRAccent under speaker-disjoint cross-validation it reaches 8.0 ± 0.8% EER. Under double leave-one-dataset-out, where an entire TTS group and an entire natural corpus are held out simultaneously, the overall EER is 6.09%, and 8.13% for the fully interpretable feature set.
On corpora built entirely from voice cloning. A cloning model follows the accent realizations of its target speaker, which narrows the variability the method relies on and makes accent-based disambiguation harder than for the general-purpose, mixed-identity voices found in commercial TTS defaults. The three markers also do not disambiguate every Brazilian variety on their own.
Data, voices and synthesis recipes
The natural side draws on publicly available Brazilian Portuguese corpora; the
download helpers live in the
pt-br-accent-toolbox
package (tools/download_datasets.py and the per-corpus scripts beside it). The synthetic side
was generated with the scripts below, each of which reads the same sentence list and writes 16 kHz mono WAV.
| Provider | Model | Voices | Voice identifiers | Settings |
|---|---|---|---|---|
| Azure AI Speech commercial | pt-BR *Neural voices | 10 | pt-BR-AntonioNeural, pt-BR-FabioNeural, pt-BR-DonatoNeural, pt-BR-HumbertoNeural, pt-BR-NicolauNeural, pt-BR-FranciscaNeural, pt-BR-BrendaNeural, pt-BR-ElzaNeural, pt-BR-GiovannaNeural, pt-BR-LeticiaNeural | SSML, 16 kHz PCM output |
| Google Cloud TTS commercial | pt-BR Neural2 / WaveNet / Standard | 10 | pt-BR-Neural2-A, pt-BR-Neural2-C, pt-BR-Wavenet-A, pt-BR-Wavenet-D, pt-BR-Standard-A, pt-BR-Neural2-B, pt-BR-Wavenet-B, pt-BR-Wavenet-C, pt-BR-Wavenet-E, pt-BR-Standard-B | LINEAR16, 16 kHz |
| OpenAI TTS commercial | tts-1-hd | 9 | onyx, echo, fable, ash, nova, shimmer, alloy, coral, sage | PCM 24 kHz, resampled to 16 kHz |
| ElevenLabs commercial | eleven_multilingual_v2 | 10 | 36rVQA1AOIPwpA3Hg1tC, tS45q0QcrDHqHoaWdCDR, CstacWqMhJQlnfLPxRG4, hwnuNyWkl9DjdTFykrN6, YNOujSUmHtgN6anjqXPf, 33B4UnXyTNbgLmdEDh5P, lWq4KDY8znfkV0DrK8Vb, oJebhZNaPllxk6W0LSBA, RGymW84CSmfVugnA5tvA, cyD08lEy76q03ER1jZ7y | stability 0.5, similarity_boost 0.75, pcm_16000 |
| F5-TTS pt-BR open-source | firstpixel/F5-TTS-pt-br | 2 | f5_ptbr_male, f5_ptbr_female | zero-shot cloning of two ~8 s Azure reference clips |
| Qwen3-TTS open-source | Qwen/Qwen3-TTS-12Hz-1.7B-CustomVoice | 9 | aiden, dylan, eric, ono_anna, ryan, serena, sohee, uncle_fu, vivian | bfloat16, preset voices, resampled to 16 kHz |
| Piper open-source | pt_BR voices (rhasspy/piper) | 4 | pt_BR-cadu-medium, pt_BR-edresson-low, pt_BR-faber-medium, pt_BR-jeff-medium | ONNX, 16 kHz native |
| Kokoro open-source | hexgrad/Kokoro-82M | 3 | pf_dora, pm_alex, pm_santa | lang_code 'p', 24 kHz resampled to 16 kHz |
57 voices in total, each synthesizing the same 50 sentences. Voice identifiers and model names are parsed directly from the synthesis scripts linked in the provider name, which are the scripts that produced the corpus. Synthesis ran between April and June 2026; commercial providers may since have updated the underlying models.
API credentials are never stored in these scripts: commercial providers take a
--key argument or an environment variable.
Synthesis prompt texts
- No total, sete mísseis foram disparados contra o encrave.
- Até agora, na televisão, eles já somam quatro ministros.
- Os dois times perderam uma chance atrás da outra.
- Os médicos ainda não sabem quanto tempo ele deverá ficar no hospital.
- Tenho muita vontade de aprender, mas baixo poder aquisitivo.
- Apesar disso, continua ligado ao seu país de origem.
- Evite correr ao banco para trocar o seu dinheiro.
- Em grande fase, é a nova sensação do time.
- Respondeu que a sua frase havia sido tirada do contexto.
- Na Universidade de Paris Três é só isso que se faz.
- A Coréia exporta um bilhão de dólares em móveis por ano.
- A polícia apreendeu nos últimos vinte dias, sessenta carros a seu serviço.
- Segundo ele, foi apenas um almoço rápido entre amigos.
- É muito raro que algum documentário esteja na lista deles.
- O novo presidente seria conhecido quatro dias após a votação.
- Segundo Almeida, é praticamente impossível controlar o fogo sem ajuda exterior.
- A justiça brasileira considerou o fato apenas um crime comum.
- A decisão está para ser tomada em fevereiro ou março.
- A melhoria da qualidade não interessa só a técnicos ou empresários.
- No final era um monte de homens se abraçando e chorando.
- A margem de erro é de três pontos percentuais.
- Juliana disse que o banco a ser escolhido é surpresa.
- O vencedor de cada grupo ganha um ponto extra.
- Estava muito calor e não soubemos dosar a energia.
- Segundo ele, a cabine não faz parte do edifício.
- Esse nosso sintetizador de voz vai ficar uma beleza.
- Empresa que serve ao Ministério da Fazenda aluga comitê aos tucanos.
- Os grandes bancos estão procurando apoiar as pequenas instituições.
- Outro obstáculo às relações afetivas é a competitividade interna.
- Sem a retirada, os muçulmanos não compareceram às negociações.
- Ele, ainda meio confuso, volta para perto da Constituição.
- Itamar pode faltar a Mercosul para ir à posse do presidente colombiano.
- Tem lucro de um bilhão de dólares por ano.
- Os belgas reclamaram, mas o juiz não deu o pênalti.
- O Brasil está perdendo pouco a pouco a sua identidade.
- É mais importante saber o que fazem os jogadores no campo.
- Comprei um jogo de canetas e fui visitá-lo em sua casa.
- Meu tipo inesquecível é o advogado Francisco Rangel Pestana.
- Empregado do Parlamento Europeu, ele tinha ligações com a bancada socialista.
- As entradas podem ser adquiridas pelo telefone acima.
- Aliados do tucano prevêem que essas lideranças ficarão neutras.
- Perdemos uma ótima oportunidade de fazer a revisão constitucional.
- Trabalhamos exclusivamente com tipos que fogem do padrão tradicional de beleza.
- Não há, assim, motivo de temor para o Brasil.
- No dia de seu aniversário, Rose não saiu de casa.
- Somente na última rodada serão definidas as colocações das equipes.
- Em abril a taxa foi de dois vírgula seis por cento.
- Sem falar nos que ainda não acertaram o fornecimento dos motores.
- Ser progressista hoje é ligar o pensamento liberal com a social democracia.
- São tantas, que você aprende a conviver com elas.
- O truque, segundo ele, é aproveitar bem a madrugada.
- Havia possibilidade de uma nova reunião ser convocada para hoje.
- Os sobreviventes cremaram seus mortos e procuram reconstruir suas vidas.
- As importações de maçã argentina não preocupam os plantadores.
- Daqui a pouco, a violência vai ser a única diversão.
- Agora, ele despenca do teto em direção ao piso.
- A televisão virou um açougue, uma máquina de produzir.
- O governo poderá adotar ações penais por crime de omissão de socorro.
- Nunca havia ido para um treino com seguranças no ônibus.
- Eles experimentaram vários tipos de comidas exóticas durante a viagem.
- Apenas dez por cento dos funcionários em todo Brasil trabalharam ontem.
- Basta que sua remuneração não seja menor que setenta reais.
- Isso traria efeitos sobre os financiamentos habitacionais feitos com recursos da poupança.
- Esta diferença acabou se refletindo no índice de julho.
- Desconfio que não resistirão à nossa aplicada tática de jogo.
- O Brasil tem pressa e o governo está pronto para agir.
- Todos os dias, das dezessete horas ao último cliente.
- Quero estar no grupo e ajudar sempre que necessário.
- Venda de veículos no varejo bate novo recorde em maio.
- Eu vi apenas dois videoteipes dos amistosos contra Argentina e Alemanha.
- Os investidores foram para a Argentina e para a Venezuela.
- Para ele, a concorrência é boa para os consumidores.
- As pessoas se divertiram tanto que aplaudiram de pé.
- A perspectiva continua otimista para o médio e longo prazos.
- Existem péssimas edições do livro, por isso, use o da Edição Pensamento.
- Ele defende a formulação de um programa mínimo para evitá-la.
- Outros produtos também lembrados: feijão, café e derivados de soja.
- Eu queria fazer minhas próprias coisas e logo caí na real.
- Quatro homens entraram separadamente pela porta principal da agência.
- Eu acabo de receber uma crítica muito elogiosa aqui no Canadá.
- O seqüestro de bens serviria para garantir o pagamento.
- É uma política oportuna e bem conduzida até agora.
- Vamos esquecer o passado, vamos pensar no presente e no futuro.
- Depois que a Mangueira passar, o suspense dominará a passarela.
- No entender do advogado Celso Botelho de Moraes não há inconstitucionalidade.
- Primeiro arredondou a idade do percussionista para cinqüenta anos.
- O curso é gratuito e tem a duração de seis meses.
- O mais desculpável em Itamar são os seus vexames de passarela.
- O termo caça-níqueis se aplica exatamente aos dois jogos.
- Ela disse que o Alcorão deveria ser revisado cuidadosamente.
- O grupo chegou quando os amotinados já tinham saído.
- O ministério diz que não foi consultado sobre a transação.
- O número de convocados por vaga é de doze candidatos.
- Para discutir sobre ecologia e projetos para gerações futuras.
- Fiz o que a maioria procurou fazer: evitei provocar marola.
- Eu não quero e não vou falar sobre câmbio e juros.
- O partido precisaria, de resto, abrir-se para composições políticas.
- A mãe de todas as reformas é a reforma política.
- A permanecer a atual situação, será o Brasil que não vingará.
- Só para o curso de inglês é necessário conhecimento da língua.
The 10 longer texts
- Todas as manhãs, antes de sair para o trabalho, eu costumo tomar um café bem forte e ler as notícias mais importantes do dia. As ruas da cidade ficam cheias de carros, ônibus e pessoas apressadas que precisam chegar cedo aos seus compromissos. Os estudantes correm para as escolas, os trabalhadores esperam nos pontos de ônibus, e os vendedores já começam a montar suas barracas nas esquinas. Eu gosto de observar esse movimento constante enquanto caminho pelas calçadas, prestando atenção nos detalhes que muita gente nem percebe. Às vezes encontro velhos amigos pela rua e paramos para conversar sobre as novidades, sobre os planos para o futuro e sobre as dificuldades que enfrentamos todos os dias. Depois sigo o meu caminho, sempre com pressa, mas tentando aproveitar cada instante dessa rotina que, apesar de cansativa, também tem o seu charme particular.
- Na semana passada, decidimos finalmente realizar aquela viagem que vínhamos adiando havia tanto tempo por causa do trabalho e das obrigações. Saímos de madrugada, com as malas cheias e o carro abastecido, prontos para enfrentar as longas estradas que cortam o interior do estado. Durante o percurso, passamos por pequenas cidades históricas, paramos para almoçar em restaurantes simples à beira da rodovia e conversamos sobre as lembranças da nossa infância. As paisagens mudavam constantemente: ora montanhas verdes e úmidas, ora planícies secas e douradas sob o sol forte da tarde. Quando chegamos ao nosso destino, já era quase noite, e as luzes da pousada nos receberam com um brilho acolhedor. Cansados mas felizes, jantamos devagar, brindamos à amizade verdadeira e dormimos profundamente, certos de que aqueles dias ficariam para sempre guardados na memória.
- Cozinhar para os amigos sempre foi uma das minhas maiores paixões, especialmente nos finais de semana, quando o tempo permite preparar pratos mais elaborados e demorados. Costumo começar separando todos os ingredientes sobre a bancada: os temperos frescos, as carnes, os legumes coloridos e os queijos que comprei na feira pela manhã. Enquanto as panelas fervem no fogão, vou ajustando o sal, provando os molhos e corrigindo os sabores com paciência e atenção. O cheiro que se espalha pela casa atrai todos para a cozinha, e logo começam as conversas animadas sobre comida, viagens e receitas de família. Quando finalmente servimos o jantar, sinto uma satisfação enorme ao ver os pratos vazios e os sorrisos contentes dos convidados. Para mim, não existe presente maior do que reunir as pessoas queridas ao redor de uma mesa farta e bem preparada.
- Trabalhar em uma grande empresa exige muita disciplina, organização e capacidade de lidar com pessoas de diferentes personalidades e interesses. Todas as manhãs, antes mesmo de abrir o computador, eu reviso minha lista de tarefas e estabeleço as prioridades do dia para não me perder no meio de tantas reuniões e solicitações. Os colegas costumam aparecer na minha sala com dúvidas urgentes, relatórios pendentes e projetos que precisam ser entregues dentro de prazos cada vez mais apertados. Apesar da pressão constante, procuro manter a calma, responder os e-mails com clareza e tratar todos com respeito e gentileza. No final da tarde, quando o escritório começa a esvaziar, aproveito o silêncio para revisar os documentos importantes e planejar as atividades do dia seguinte. Saio do prédio cansado, mas com a sensação de dever cumprido e de mais um desafio vencido.
- O inverno na serra costuma ser rigoroso, com manhãs geladas, neblinas densas e ventos cortantes que descem das montanhas durante a madrugada. As pessoas que moram nessas regiões aprendem desde cedo a respeitar a força da natureza e a se preparar para os dias mais difíceis do ano. Logo após o amanhecer, os moradores acendem as lareiras, vestem casacos pesados e saem para cuidar dos animais e das plantações que resistem ao frio intenso. Os rios descem cristalinos entre as pedras, e as árvores perdem as folhas, deixando os galhos nus contra o céu acinzentado. Quando o sol finalmente aparece, ainda que tímido, todos param para apreciar a beleza tranquila daquela paisagem silenciosa. À noite, reunidos ao redor do fogo, contam histórias antigas e bebem chás quentes, esperando que a primavera chegue logo para aquecer novamente os corações e os campos.
- Quando lembro dos meus tempos de escola, sinto uma mistura de saudade e gratidão por tudo o que vivi naqueles anos importantes da minha formação. As salas de aula eram simples, mas os professores dedicados conseguiam despertar em nós a curiosidade e o desejo constante de aprender coisas novas. Eu adorava as aulas de história e de literatura, nas quais discutíamos grandes acontecimentos e líamos textos que ampliavam os nossos horizontes. Nos intervalos, corríamos pelo pátio, dividíamos os lanches e inventávamos brincadeiras que nos faziam rir até perder o fôlego. Havia também os dias de prova, cheios de tensão e nervosismo, quando estudávamos até tarde tentando memorizar todas as matérias. Apesar das dificuldades, aqueles momentos construíram amizades verdadeiras e ensinamentos que carrego comigo até hoje, sempre que preciso enfrentar os desafios da vida adulta com coragem e determinação.
- A tecnologia transformou completamente a maneira como vivemos, trabalhamos e nos relacionamos uns com os outros ao longo das últimas décadas. Hoje em dia, carregamos no bolso aparelhos poderosos que nos permitem acessar informações, conversar com pessoas distantes e resolver problemas complexos em questão de segundos. As empresas investem pesado em inteligência artificial, automação e sistemas digitais que prometem facilitar as tarefas mais repetitivas do cotidiano. No entanto, é preciso usar essas ferramentas com responsabilidade e equilíbrio, para não perder o contato verdadeiro com as pessoas e com o mundo real ao nosso redor. Muitos especialistas alertam sobre os perigos do excesso de telas, da dependência constante e da falta de privacidade nas redes sociais. Cabe a cada um de nós encontrar um caminho saudável, aproveitando os benefícios dos avanços modernos sem abrir mão da nossa humanidade e do tempo dedicado a quem amamos.
- As festas populares brasileiras representam uma das manifestações culturais mais ricas e diversas de todo o nosso imenso território nacional. Durante o mês de junho, por exemplo, as cidades do interior se enchem de bandeirinhas coloridas, fogueiras acesas e barracas que vendem comidas típicas deliciosas. As pessoas se vestem com roupas caipiras, dançam quadrilha nas praças e celebram juntas as tradições herdadas dos seus antepassados. O som das sanfonas, dos triângulos e das zabumbas ecoa pelas ruas durante noites inteiras de muita alegria e descontração. Crianças correm de um lado para o outro segurando balões, enquanto os adultos conversam, riem e relembram as festas de outros tempos. Esses encontros fortalecem os laços comunitários e mantêm vivas as raízes culturais que definem a identidade do nosso povo, transmitindo de geração em geração os valores, os costumes e as histórias que nos tornam quem somos.
- Cuidar da saúde do corpo e da mente tornou-se uma prioridade indispensável para quem deseja viver com qualidade e disposição. Os médicos recomendam praticar exercícios físicos regularmente, manter uma alimentação equilibrada e dormir as horas necessárias para que o organismo se recupere adequadamente. Caminhar ao ar livre pela manhã, por exemplo, ajuda a reduzir o estresse, fortalecer os músculos e melhorar o funcionamento do coração. Além disso, é fundamental beber bastante água, evitar os alimentos industrializados e reservar momentos de descanso ao longo do dia agitado. Muitas pessoas descobrem que pequenas mudanças nos hábitos diários produzem resultados surpreendentes na saúde física e emocional. Reservar um tempo para meditar, ler um bom livro ou simplesmente conversar com os amigos também contribui enormemente para o bem-estar geral. No fim das contas, a verdadeira riqueza está em manter o equilíbrio entre as obrigações e os prazeres da vida.
- A família é, sem dúvida, o alicerce mais importante da nossa vida, o porto seguro para onde sempre retornamos nos momentos felizes e difíceis. Desde a infância, aprendemos com os nossos pais os valores fundamentais que nos acompanham por toda a existência: o respeito, a honestidade e a generosidade. Nos finais de semana, costumamos nos reunir na casa dos avós para almoçar, conversar e relembrar as histórias engraçadas que marcaram a nossa trajetória. As crianças brincam no quintal, os adultos trocam notícias e os mais velhos compartilham conselhos preciosos baseados na sabedoria de quem já viveu bastante. Mesmo quando surgem desentendimentos e discussões, o amor verdadeiro sempre fala mais alto e nos mantém unidos diante de qualquer adversidade. Por isso, devemos valorizar cada instante ao lado das pessoas que amamos, pois são essas lembranças que construímos juntos que dão sentido profundo à nossa caminhada.
Experimental setup
Pool composition, front-end settings, feature definitions and model hyperparameters for every experiment in the paper.
| Natural speech pool | |
|---|---|
| Speakers (Tables I-II, Fig. 1-3) | 364 = 210 TAGARELA/Spotify + 92 annotated + 62 BRSpeech-DF bonafide |
| Speakers (Table V, double LODO) | 281 = 189 TAGARELA/Spotify + 92 annotated (BRSpeech-DF excluded) |
| Source corpora | CORAA (CORAL, NURC-RE, TED), Mozilla Common Voice, CoLingPB, CML-TTS, NURC-SP, Certas Palavras, CETUC/Alcaim, TAGARELA (Spotify podcasts) |
| Selection criterion | multiple dialects and multiple recording chains, filtered for sample quality; no sociolinguistic labels used for selection |
| Synthetic speech pool | |
| Voices | 57 TTS voices x 50 sentences (39 commercial + 18 open-source) |
| Text set | the same 50 phonetically balanced sentences for every voice (sentences_50.txt) |
| Output format | 16 kHz mono PCM WAV; providers returning another rate are resampled with torchaudio |
| Cross-dataset benchmarks | |
| BRSpeech-DF | official train/validation/test splits (Table III) |
| FakeBRAccent | no official split; speaker-disjoint 5-fold CV over 10 seeds, since the same speaker appears in both bonafide and spoof parts (Table IV) |
| MLAAD (pt subset) | 16 TTS systems; synthetic only, so training always draws natural speech from the other sources (Table V) |
| Audio front-end | |
| Sample rate | 16 kHz mono throughout |
| Marker localization | ZIPA phone recognizer in forced-alignment mode (ONNX CTC, 20 ms frames) |
| Marker window | +/- 80 ms around the detected marker frame; /d,t/ uses a broad window for spectral moments and a narrow +/- 2-frame window for ZIPA probabilities |
| PhoneticXeus | group-pooled phone logits at the same marker frames (+/- 2 frames) |
| Vowel formants | parselmouth Burg, 5 formants, 5000 Hz ceiling, 25 ms window, 50 Hz pre-emphasis, queried at ZIPA vowel spikes |
| Channel normalization (Table V only) | librosa silence trim at top_db=30, RMS normalization to 0.05 with 0.99 peak safety, and cepstral mean normalization of the MFCC block |
| Feature blocks | |
| ZIPA (46D) | 6 spectral moments + windowed CTC phone posteriors for each of the three markers |
| Formants (29D) | per-vowel mean F1/F2/F3 for a, E, e, i, O, o, u (21D) + long-term formant mean/SD (6D) + long-term F0 mean/SD (2D) |
| PhoneticXeus | group-pooled phone logits at marker positions |
| Aggregation | per-speaker mean over that speaker's clips; missing vowels imputed with the natural-pool column mean |
| Models and cross-validation | |
| KDE (Table I) | Gaussian kernel, bandwidth 2x Scott, OOD threshold at the 5th percentile of the training log-likelihood, 5-fold, seed 42 |
| Dimensionality reduction | t-SNE perplexity 40 / 1000 iterations / PCA init (transductive); Isomap 15 neighbours; PCA 5 components; seed 42 |
| Supervised detection (Table II) | XGBoost 400 trees, depth 4, lr 0.05, subsample and colsample 0.8; balanced 5-fold CV over 20 seeds; StandardScaler |
| Cross-dataset (Table V) | XGBoost 400 trees, depth 5, lr 0.05, subsample and colsample 0.8, scale_pos_weight, seed 0 |
| Realization classifiers (Fig. 4) | XGBoost 300 trees, depth 4, lr 0.05, subsample and colsample 0.9, L2 1.0, seed 0, on [spec6 | ZIPA | PhoneticXeus logits] |
| Metric | EER computed by sweeping the score threshold; accuracy at the EER operating point |
More feature distributions
Marker-localized features
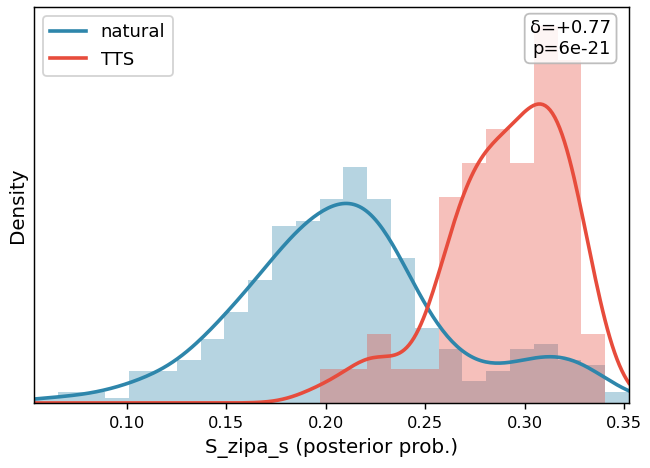
S_zipa_s · /s/ coda · δ=+0.77, p=6e-21 · SHAP+RF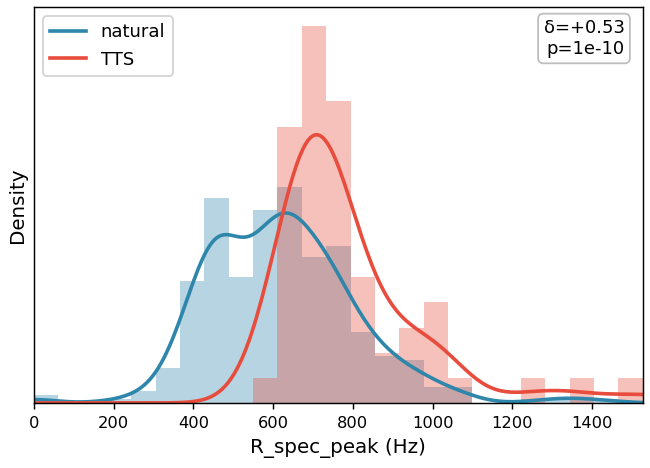
R_spec_peak · /r/ coda · δ=+0.53, p=1e-10 · SHAP+RF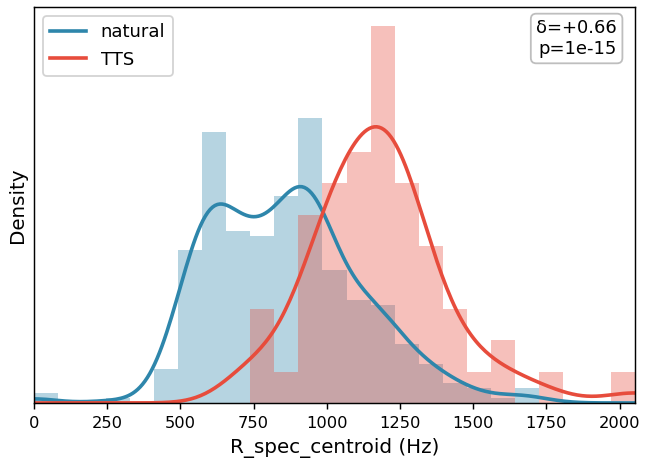
R_spec_centroid · /r/ coda · δ=+0.66, p=1e-15 · SHAP+RF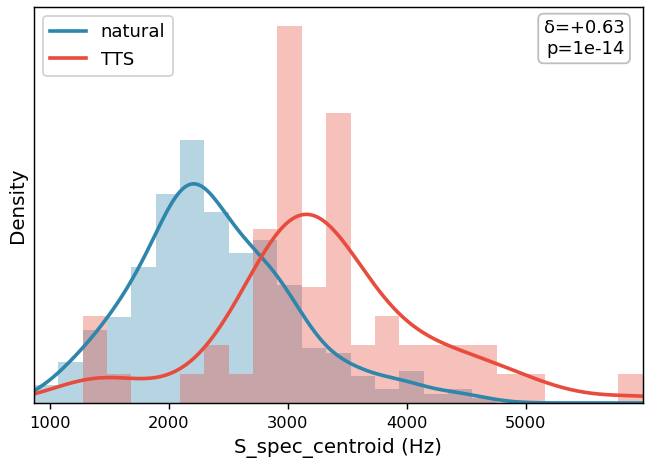
S_spec_centroid · /s/ coda · δ=+0.63, p=1e-14 · SHAP+RF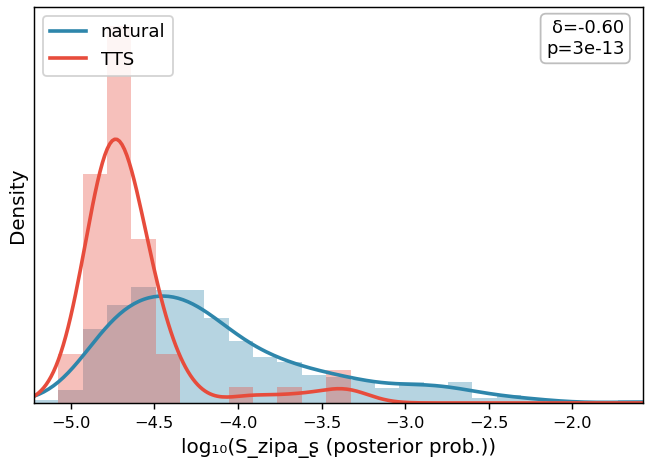
S_zipa_ʂ · /s/ coda · δ=-0.60, p=3e-13 · SHAP+RF · log axis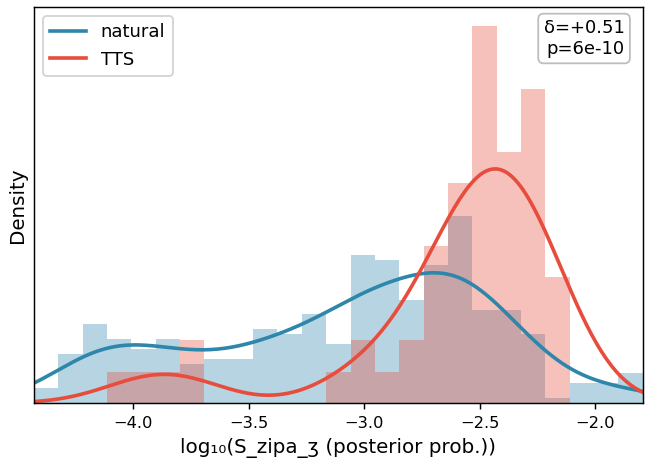
S_zipa_ʒ · /s/ coda · δ=+0.51, p=6e-10 · SHAP · log axis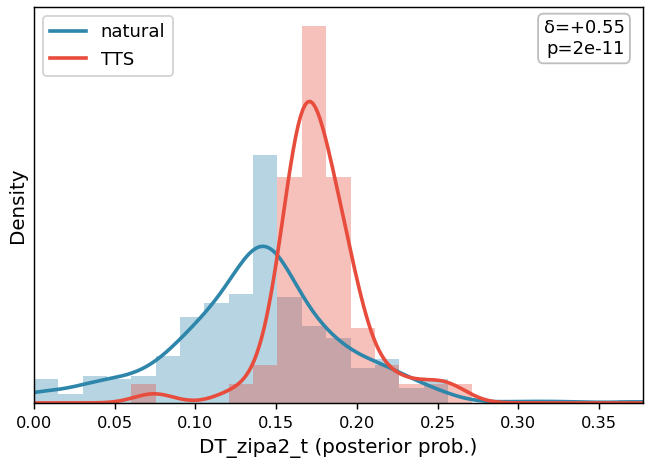
DT_zipa2_t · /d,t/ palatalization · δ=+0.55, p=2e-11 · SHAP+RF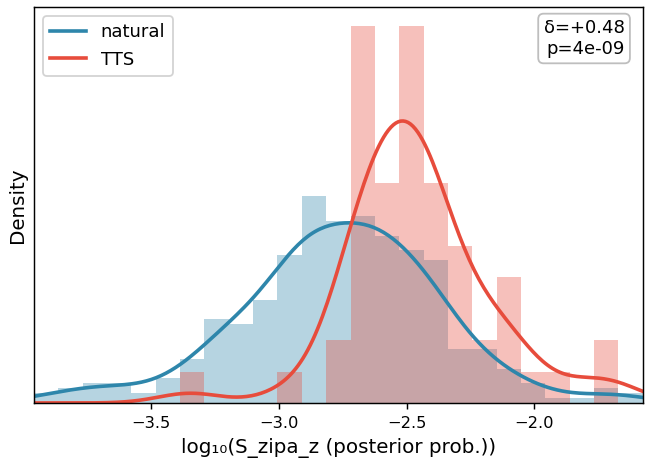
S_zipa_z · /s/ coda · δ=+0.48, p=4e-09 · SHAP · log axis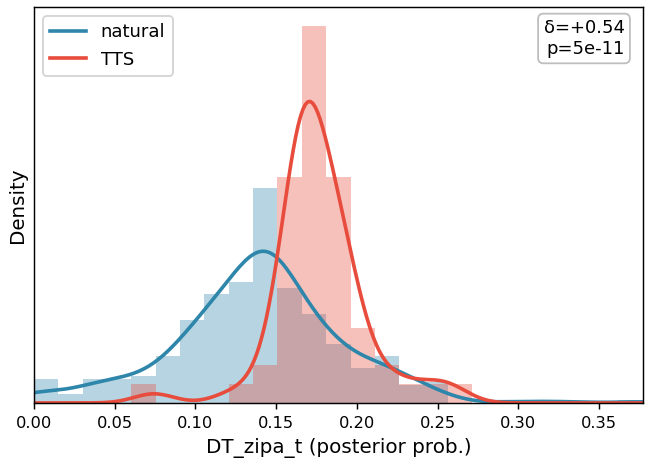
DT_zipa_t · /d,t/ palatalization · δ=+0.54, p=5e-11 · SHAP+RF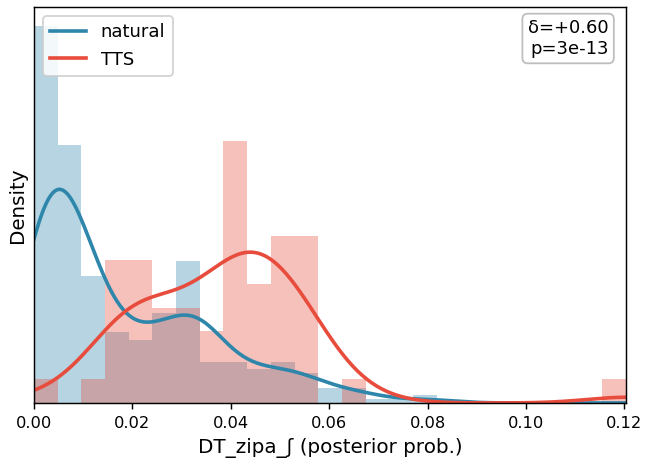
DT_zipa_ʃ · /d,t/ palatalization · δ=+0.60, p=3e-13 · SHAP+RF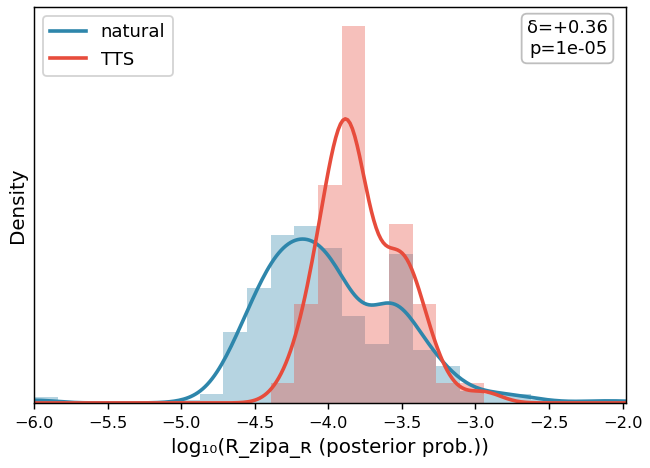
R_zipa_ʀ · /r/ coda · δ=+0.36, p=1e-05 · SHAP · log axis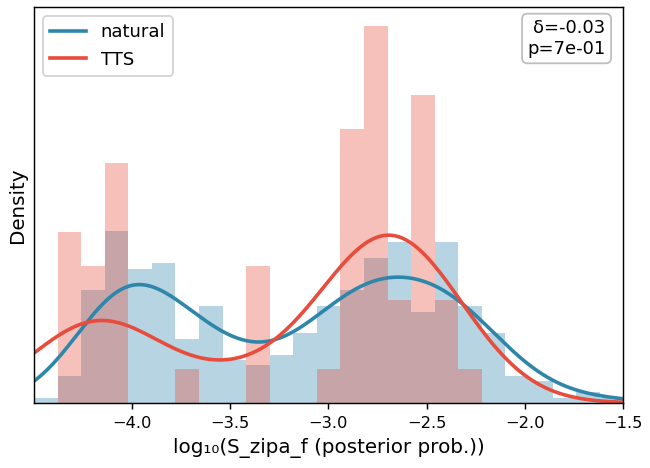
S_zipa_f · /s/ coda · δ=-0.03, p=7e-01 · SHAP · log axis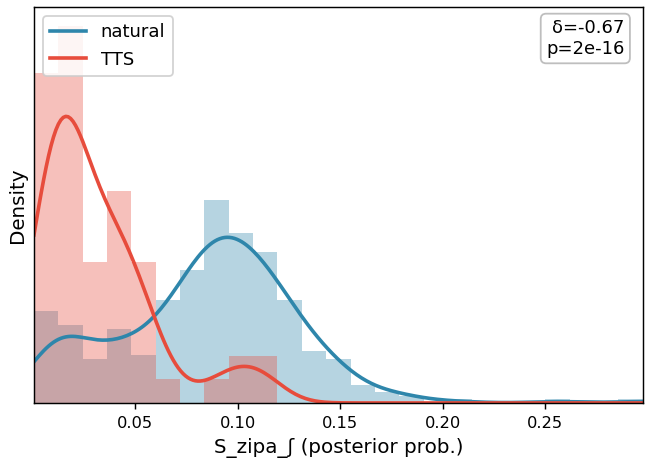
S_zipa_ʃ · /s/ coda · δ=-0.67, p=2e-16 · RF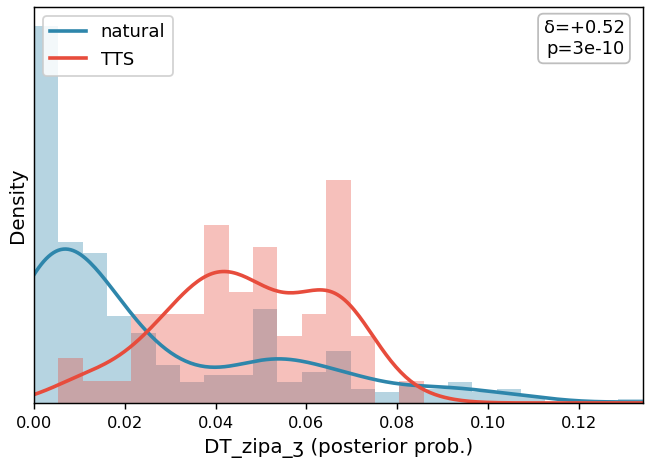
DT_zipa_ʒ · /d,t/ palatalization · δ=+0.52, p=3e-10 · RF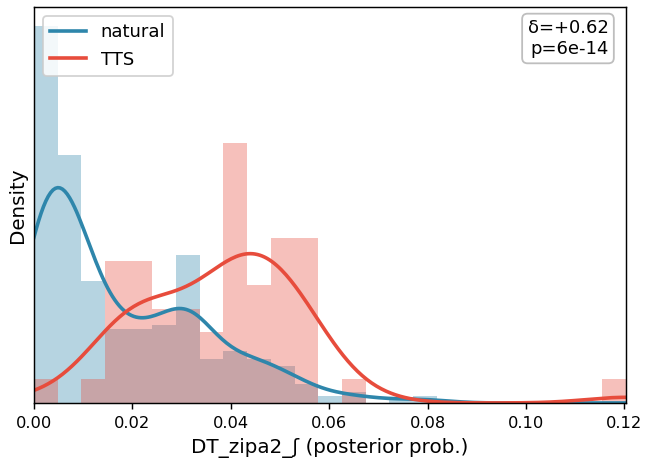
DT_zipa2_ʃ · /d,t/ palatalization · δ=+0.62, p=6e-14 · RF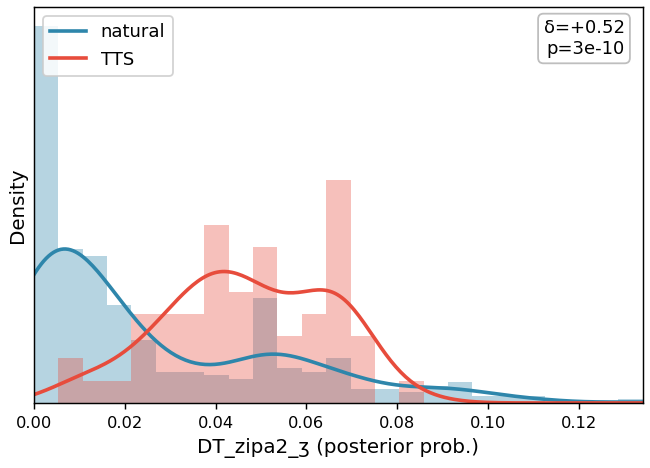
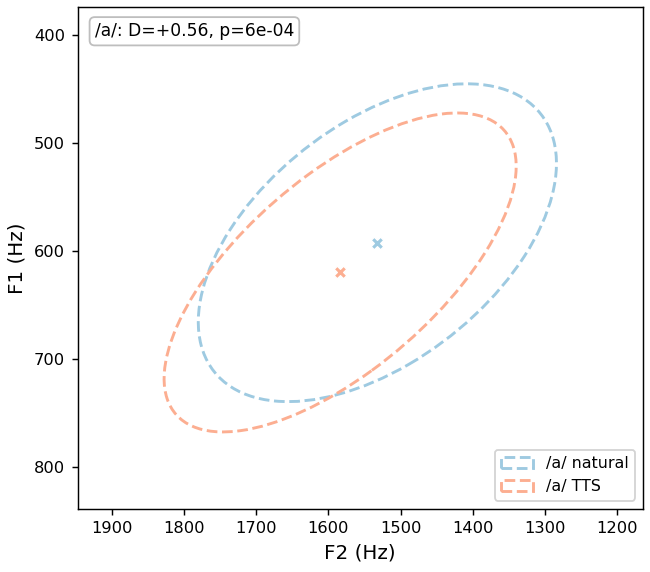
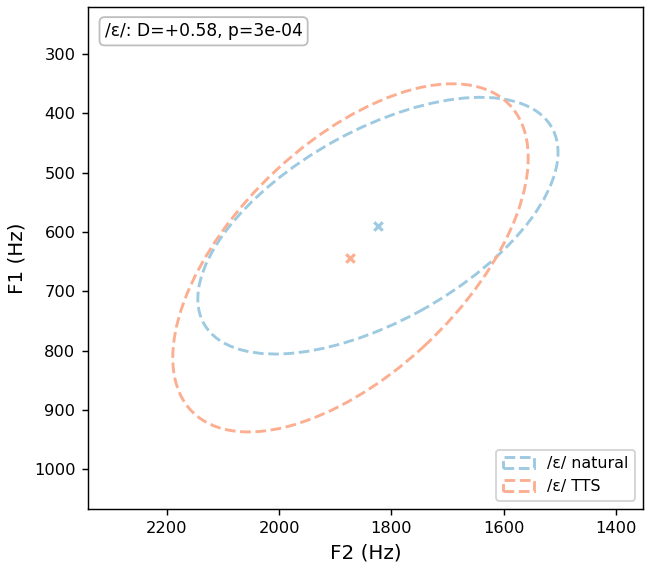
DT_zipa2_ʒ · /d,t/ palatalization · δ=+0.52, p=3e-10 · RFVowel spaces (F1 × F2, 95% ellipses)
Effect size for every feature
| Feature | Family | Natural median | Synthetic median | Cliff's δ | Mann-Whitney p |
|---|---|---|---|---|---|
| S_zipa_s | zipa | 0.2084 | 0.2958 | +0.773 | 6.2e-21 |
| S_zipa_ʃ | zipa | 0.08969 | 0.02114 | -0.675 | 2.5e-16 |
| R_spec_centroid | zipa | 855.5 | 1172 | +0.661 | 9.9e-16 |
| S_spec_variance | zipa | 1.884e+06 | 2.74e+06 | +0.634 | 1.4e-14 |
| S_spec_centroid | zipa | 2296 | 3214 | +0.633 | 1.5e-14 |
| DT_zipa2_ʃ | zipa | 0.01145 | 0.04069 | +0.619 | 5.5e-14 |
| DT_zipa_ʃ | zipa | 0.01137 | 0.04069 | +0.602 | 2.6e-13 |
| S_zipa_ʂ | zipa | 5.181e-05 | 1.808e-05 | -0.601 | 3.0e-13 |
| R_spec_variance | zipa | 3.023e+05 | 5.513e+05 | +0.563 | 8.0e-12 |
| S_spec_logBR | zipa | -0.2791 | 0.1812 | +0.561 | 9.3e-12 |
| MF_i_F3 | formant | 2790 | 2904 | +0.555 | 1.6e-11 |
| DT_zipa2_t | zipa | 0.1426 | 0.1711 | +0.551 | 2.3e-11 |
| S_spec_peak | zipa | 1506 | 2198 | +0.543 | 4.1e-11 |
| DT_zipa_t | zipa | 0.1428 | 0.1711 | +0.541 | 5.0e-11 |
| R_spec_peak | zipa | 613.5 | 733.9 | +0.529 | 1.3e-10 |
| MF_u_F1 | formant | 550.2 | 669.4 | +0.529 | 1.4e-10 |
| DT_zipa2_ʒ | zipa | 0.01452 | 0.04539 | +0.520 | 2.8e-10 |
| DT_zipa_ʒ | zipa | 0.01421 | 0.04539 | +0.517 | 3.4e-10 |
| MF_i_F2 | formant | 1922 | 2047 | +0.511 | 5.3e-10 |
| S_zipa_ʒ | zipa | 0.001135 | 0.003197 | +0.510 | 5.9e-10 |
| S_zipa_z | zipa | 0.001823 | 0.00323 | +0.484 | 4.1e-09 |
| LTFD_F1m | formant | 584.7 | 640.6 | +0.468 | 1.3e-08 |
| MF_i_F1 | formant | 606.5 | 734.5 | +0.455 | 3.4e-08 |
| S_spec_skew | zipa | 1.52 | 0.9438 | -0.435 | 1.3e-07 |
| S_zipa_ɕ | zipa | 8.013e-05 | 2.354e-05 | -0.424 | 2.6e-07 |
The 25 features with the largest absolute effect size, out of the 75 in the phonological feature space. The complete table is available as a CSV below. These p-values are not corrected for multiple comparisons and the features were chosen by an importance ranking fitted on the same data, so they describe the observed separation rather than test a pre-registered hypothesis.
Within-utterance switching: classifier accuracy
Figure 4 of the paper measures how often a voice changes its realization of the same marker inside one utterance, using the binary Shannon entropy of the per-utterance mean dialectal probability given by a realization classifier.
Realization-classifier accuracy
| Marker | Accuracy | Chance |
|---|---|---|
| S | 0.781 | 0.500 |
| R | 0.635 | 0.333 |
| DT | 0.813 | 0.500 |
Cross-dataset detection, per held-out group
The paper’s Table V reports a double leave-one-dataset-out protocol: for every pair of one held-out TTS group and one held-out natural corpus, a detector is trained on everything else and evaluated on that pair. This gives 24 synthetic groups (8 curated TTS providers and 16 MLAAD systems) × 7 natural corpora = 168 held-out cells per feature set. The tables below open up the two feature sets reported in the paper.
| Feature set | Overall EER (%) | Curated dataset | MLAAD |
|---|---|---|---|
| ECAPA+Formants (221D) | 6.09 | 11.30 | 3.49 |
| ZIPA+PX+Formants (121D) | 8.13 | 12.13 | 6.13 |
The paper’s Table V values: means over the whole cross, weighted by the number of speakers in each held-out natural fold. Because the TAGARELA/Spotify fold carries 189 of the 281 natural speakers, it dominates that average.
By held-out TTS group
| Held-out TTS group | Source | Voices / systems | ECAPA+Formants EER (%) | ZIPA+PX+Formants EER (%) |
|---|---|---|---|---|
| azure | curated | 10 | 4.95 | 7.44 |
| elevenlabs | curated | 10 | 12.49 | 11.10 |
| f5 | curated | 2 | 22.06 | 32.03 |
| curated | 10 | 12.03 | 15.80 | |
| kokoro | curated | 3 | 1.07 | 0.71 |
| openai | curated | 9 | 3.79 | 3.36 |
| piper | curated | 4 | 31.40 | 19.84 |
| qwen3 | curated | 9 | 2.61 | 6.76 |
| Fish-S2-Pro | MLAAD | 4 | 0.36 | 0.00 |
| Hume TADA-3B-ML | MLAAD | 4 | 1.07 | 10.49 |
| LEMAS-TTS | MLAAD | 4 | 1.07 | 0.36 |
| Llasa-1B-Multilingual | MLAAD | 1 | 2.49 | 8.90 |
| MOSS-TTS-1.7B | MLAAD | 4 | 0.36 | 1.07 |
| MOSS-TTS-8B | MLAAD | 4 | 0.36 | 6.05 |
| OmniVoice | MLAAD | 4 | 0.36 | 0.00 |
| OpenAI TTS-1 HD | MLAAD | 13 | 2.38 | 9.28 |
| Qwen3-TTS-12Hz-0.6B-Base | MLAAD | 5 | 0.71 | 0.00 |
| Qwen3-TTS-12Hz-1.7B-Base | MLAAD | 4 | 0.36 | 0.36 |
| VoxCPM2 | MLAAD | 4 | 1.07 | 15.84 |
| Voxtral | MLAAD | 2 | 9.25 | 20.82 |
| Bark | MLAAD | 1 | 34.16 | 24.91 |
| XTTS v1.1 | MLAAD | 1 | 0.00 | 0.00 |
| XTTS v2 | MLAAD | 1 | 1.42 | 0.00 |
| VITS (pt, CV) | MLAAD | 1 | 0.36 | 0.00 |
Each cell holds out that TTS group entirely — it appears in no training fold — and averages the resulting EER over the seven held-out natural corpora, weighted by their speaker counts. Groups with one or two voices give coarse EERs.
By held-out natural corpus
| Held-out natural corpus | Speakers | ECAPA+Formants: all | curated | MLAAD | ZIPA+PX+Formants: all | curated | MLAAD |
|---|---|---|---|---|---|---|---|
| TAGARELA / Spotify (RE + SP) | 189 | 3.61 | 8.33 | 1.26 | 5.84 | 13.30 | 2.10 |
| annotated — hashed IDs | 43 | 9.75 | 17.63 | 5.81 | 17.48 | 9.97 | 21.24 |
| annotated — NAME_F/M IDs | 22 | 11.51 | 17.10 | 8.72 | 11.11 | 13.43 | 9.94 |
| annotated — YouTube-style IDs | 15 | 14.82 | 16.94 | 13.75 | 5.14 | 3.75 | 5.83 |
| annotated — numeric IDs | 6 | 15.05 | 26.39 | 9.38 | 11.99 | 14.17 | 10.90 |
| annotated — lowercase-name IDs | 4 | 3.54 | 4.38 | 3.12 | 1.04 | 0.00 | 1.56 |
| annotated — other | 2 | 14.58 | 18.75 | 12.50 | 16.17 | 14.38 | 17.07 |
Each row holds out that natural corpus entirely; the EER is averaged over all 24 held-out TTS groups (and over the 8 curated / 16 MLAAD subsets). The annotated speakers are grouped by the identifier pattern of their source corpus, following the same split used in the switching experiments; folds with fewer than ten speakers are noisy.
Full grid
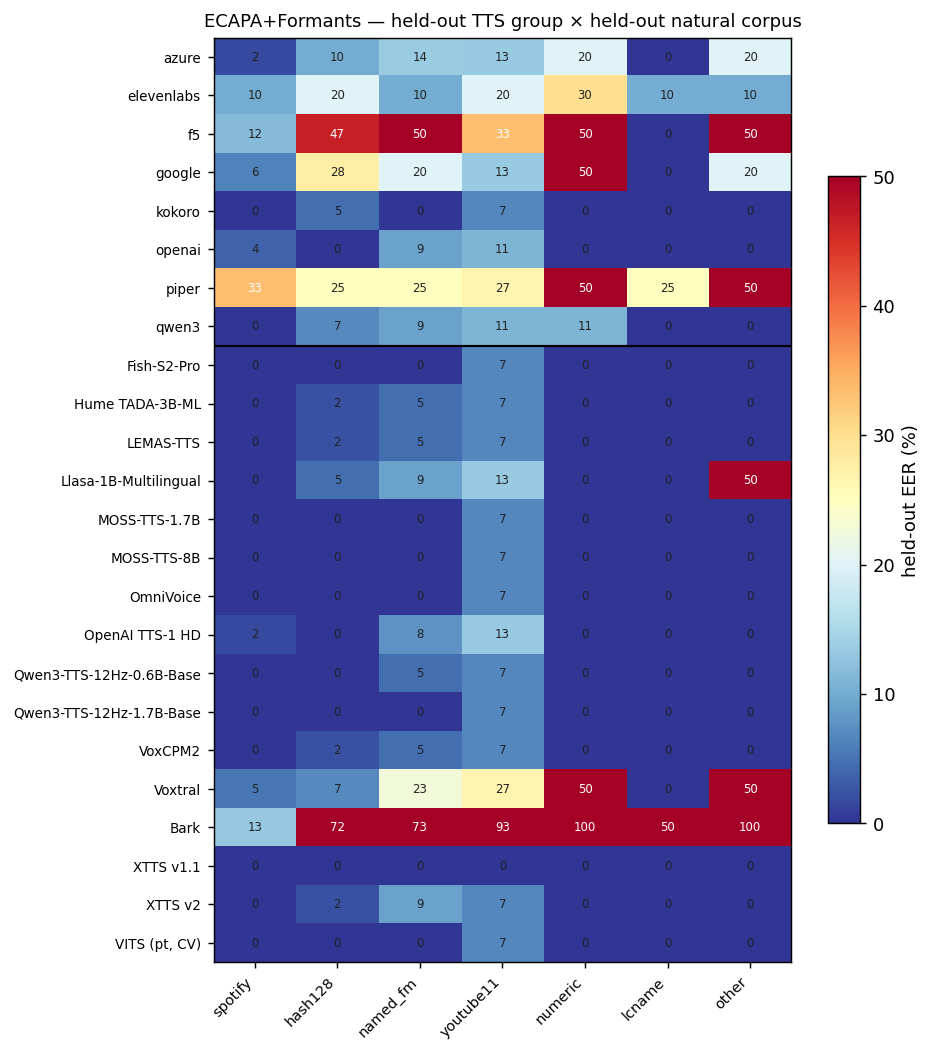
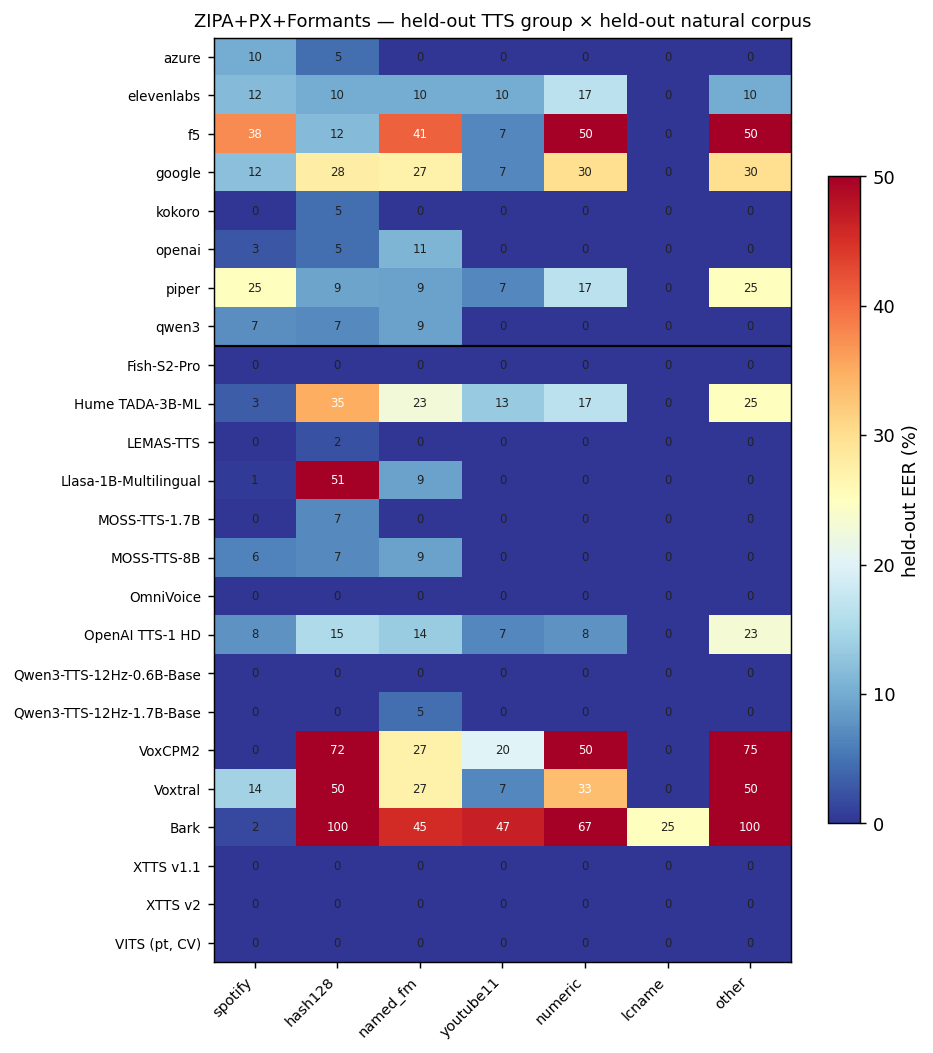
Citation
@inproceedings{leite2026synthetic,
  title     = {Synthetic speech detection in {B}razilian {P}ortuguese through accent-related features},
  author    = {Leite, Pedro H. L. and Valadares, Pedro Benevenuto and Biscainho, Luiz W. P.},
  booktitle = {Proc. IEEE Spoken Language Technology Workshop (SLT)},
  year      = {2026}
}